01. 谷歌发布西门子案例
二零二六年六月十六日,谷歌发布了一篇文章,介绍他们和西门子共同完成的一次遗留工业软件改造。
02. 任务是把桌面窗口迁到 Web
项目里的任务很具体:把原有的桌面窗口页面,迁移成现代 Web 页面。
文章没有从“模型能写多少代码”开始讲,而是详细拆解了西门子怎样理解旧系统、怎样分析改动影响,再怎样把工作交给不同的专业智能体。最终目标也不只是做出一个新页面,而是在迁移以后,继续保持原有系统的兼容性和工业软件质量标准。
03. 表面是前端重写
这项任务表面上像一次普通的前端重写:把桌面窗口改成 Web 页面,重新做按钮、表格、菜单和交互。
但这些窗口已经在工业系统里运行很多年。一个按钮后面可能连着业务规则、设备状态、权限判断和异常处理;一个字段为什么存在,答案可能藏在十年前的需求文档里。
04. 实际是迁移旧系统的行为
如果只照着旧界面重新画一遍,新页面也许看起来一样,但底层行为不一定一样。西门子真正要做的,是在不破坏原有功能的前提下,把这套界面背后的逻辑和依赖一起迁过去。
问题也就从“页面怎么做”,变成了“怎样先把旧系统看懂”。
05. 第一个难点是规模
这个项目遇到的第一个难点,是规模。西门子的代码库达到数亿行,而且持续开发了十多年。任何大模型的上下文窗口,都不可能一次装下整个系统。
普通编码智能体接到“把这个窗口改成 Web 页面”以后,只能看到当前打开的几个文件。它不知道这个窗口调用了哪些模块,不知道哪些函数被其他产品复用,也不知道哪些旧行为虽然看起来奇怪,却是兼容性要求。
这时直接生成代码,最大的问题不是写不出来,而是改动范围根本算不清。
06. 第二个难点是资料分散
第二个难点,是这套系统真正的说明书并不只在代码仓库里。
功能需求散落在 Jira 工单里,设计讨论留在 Confluence 知识页中,部分历史说明甚至还在二零零零年代早期的扫描 PDF 手册里。一行代码为什么这样写,可能需要同时查看需求单、设计文档和旧版本记录才能解释。
07. 向量库保不住资产关系
把代码单独切块放进向量库,只能找到“文字相似”的片段,却保不住一个类属于哪个文件、文件属于哪个模块,以及代码对应哪一条需求。
08. 第三个难点是算清影响
第三个难点,是在迁移之前算清改动范围。原文给了一个很具体的问题:如果修改轴控制面板的逻辑,哪些函数必须一起更新?
这就是整个项目的核心。桌面窗口迁到 Web,不是把一张页面孤立地换掉,而是要先找出它连接的函数、模块、需求和文档,再判断哪些行为必须保留,哪些依赖会被波及。
09. 先让智能体把影响范围查准
过去,这类依赖分析需要高级工程师花几天时间,在代码和历史资料之间来回查找。西门子首先要解决的不是“怎样让智能体写得更快”,而是“怎样让智能体把影响范围查准”。
10. 把代码和文档连成图
针对这些问题,西门子先从资料的组织方式入手。为了让智能体查清代码、需求和文档之间的关系,他们建立了一套知识网络系统。
团队用谷歌的 Spanner 图数据库保存软件资产之间的关系:类属于文件,文件属于模块;代码片段还能连接到设计文档里的需求条目。Jira、Confluence 和不同格式的文档,也按照它们与代码的关系进入同一张图。
这样,智能体查到一个函数以后,可以继续沿关系找到所属模块、关联需求和上下游依赖,而不是只拿到一个缺少出处的文本块。
11. 三种检索各做一件事
代码和文档连成图以后,下一步是把相关信息准确找出来。这里不能只靠一种搜索。
第一种是 GQL 图查询,用来沿着明确关系追踪依赖。第二种是 ANN 近邻向量搜索:系统给每个节点生成向量表示,用来找语义相关的代码和文档。第三种是全文检索,用来锁定精确的函数名、类名和关键词。
还是刚才那个问题:修改轴控制面板会影响哪些函数?图查询负责顺着依赖走,向量搜索负责补充语义相关资料,全文搜索负责精确命中名称。三路结果合起来,才形成可以交给工程师审核的影响证据。
12. 第一站先检索证据
三种检索找到相关证据以后,系统仍然不写代码,而是先把需求说清楚。
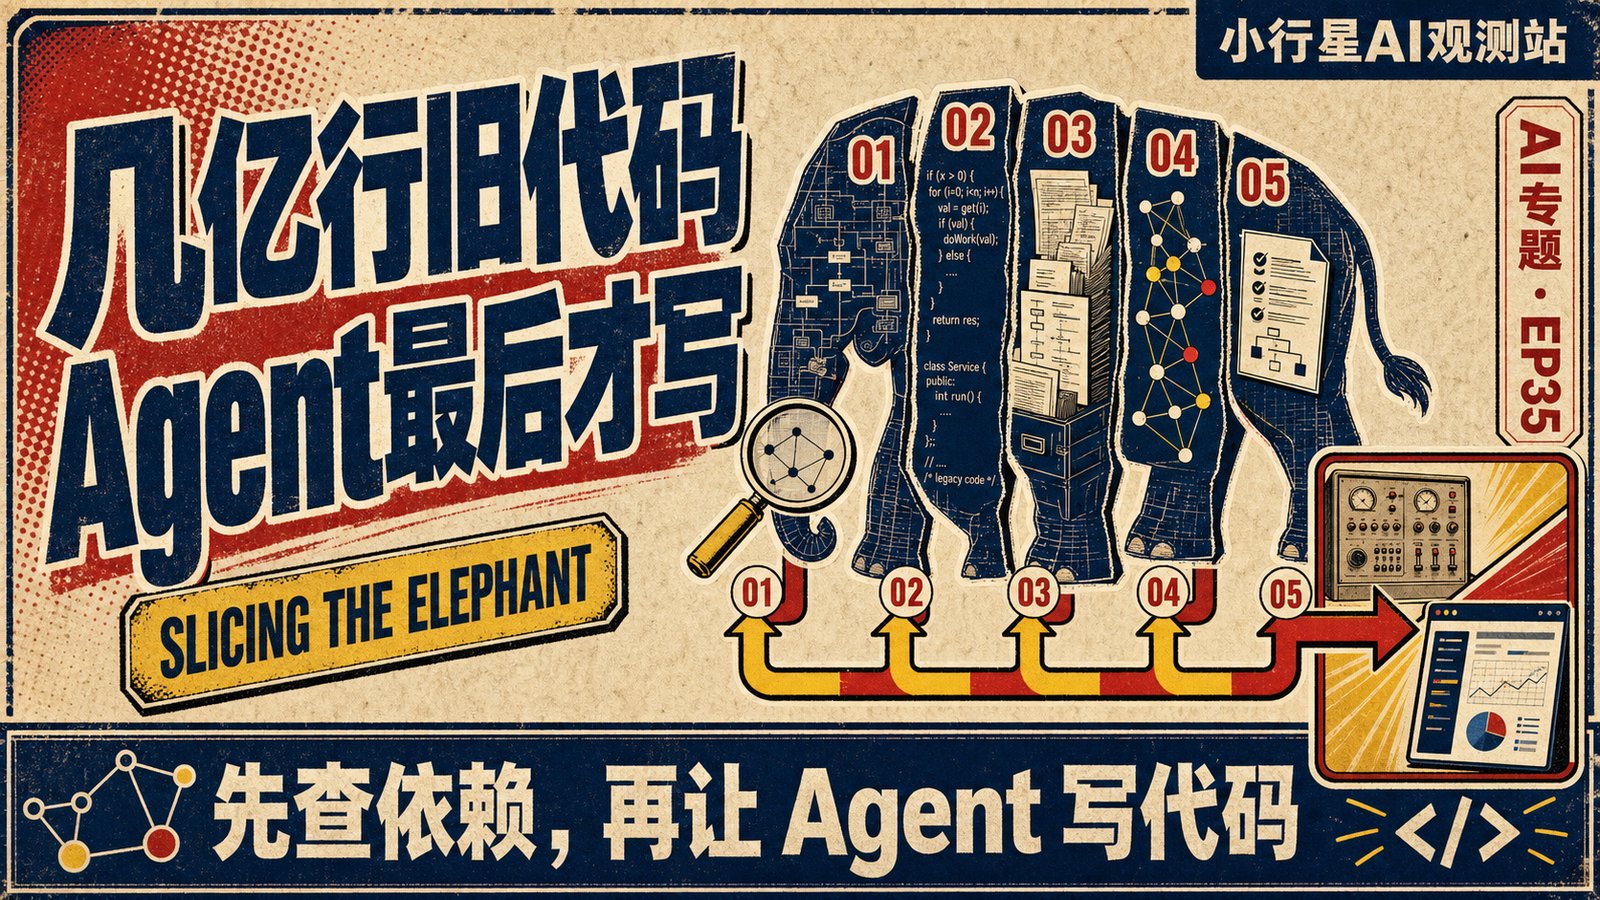
第一站是检索智能体。它继续探索代码图,并到文档搜索系统中交叉核对,把与这次界面迁移有关的代码、需求和历史说明找齐。
13. 第二站把需求变成验收条件
第二站是需求梳理智能体。它访谈产品负责人,把“迁移这个窗口”整理成详细的用户故事和验收条件。也就是明确哪些用户行为必须保留,哪些结果才算迁移完成。
到这里,原来模糊的大任务才第一次变成了可以验收的工程任务。
14. 第三站分析架构影响
需求和验收条件确定以后,第三站是架构影响分析智能体。它把用户故事和验收条件放回资产图,分析这次改动可能影响哪些函数、模块、接口和历史需求。
15. 第四站拆成带上下文的任务包
第四站是任务拆解智能体。它接收这份影响分析,把工作拆成一个个小任务。每个任务不只是一条待办事项,还要携带相关代码、依赖、需求和验收条件。
这样拆完以后,每个任务都有明确边界。后面的编码智能体不需要重新理解数亿行代码,只需要完成当前任务包里定义的那一个改动。
16. 第五站才轮到编码
搜索、需求澄清、影响分析和任务拆解全部完成以后,第五站才是编码智能体。
它接收的不是一句“把桌面窗口改成 Web”,而是一份已经做过搜索、需求澄清、影响分析和任务拆分的工作包。它知道要改什么、不能破坏什么、相关代码在哪里,以及怎样判断完成。
原文明确说,如果没有前面的上下文和分析,直接进入编码环节,会产生不可用的代码。
所以西门子的关键并不是用了五个智能体,而是把最容易出错的理解工作,全部放在生成代码之前完成。
17. 每一步都要人工审核
代码生成也不是这条流程的结束。西门子没有把五个智能体自动串起来以后,就直接合并代码。
原文明确保留了人工参与,而且是在每一步审核。工程师要检查搜索证据有没有遗漏,用户故事和验收条件是否准确,影响分析是否可信,任务拆分是否合理,再决定能不能进入下一站。
18. 审核中间制品才能定位问题
人审核的是一份份中间工程制品,而不是等几千行代码生成以后,再面对一个巨大的黑盒结果。
这也让问题更容易定位:如果代码不对,可以追查是证据漏了、需求写错了、影响分析不完整,还是任务拆分有问题。
19. 生产试点的结果
这套流程最后被用在桌面前端迁移成 Web 界面的生产试点中。文章称,它降低了总体编码工作量,同时保持系统完整性和工业质量标准。过去需要高级工程师花数天完成的依赖分析,现在所需时间明显缩短。
20. 值得学习的是影响分析
这个案例真正值得学的,不是照搬五个智能体,也不是先建设一张覆盖全公司的知识图谱,而是把“影响分析”从工程师脑子里的隐性经验,变成编码之前必须交付、必须审核的结果。
如果要在自己的项目里验证这条路线,可以先选一个旧窗口。让熟悉系统的高级工程师列出一份标准答案:它关联哪些函数和模块,依赖哪些需求与文档,迁移后哪些行为不能改变。
21. 先回答三个问题
然后先不要让智能体写代码,只让系统回答三个问题:需要改哪里,为什么要改,会影响什么。每个答案都必须带回代码或文档来源,再由工程师检查有没有漏项。
22. 通过审核以后再编码
只有影响分析能够稳定通过审核,才继续生成验收条件、拆分任务并进入编码。评估效果时,也不要统计生成了多少行代码,而要看依赖找全了没有、工程师复核花了多久、迁移后出现了多少回归问题。
参考资料与延伸阅读
本文事实来源
主来源
- 发布方:Google Cloud / Siemens
- 日期:2026-06-16
- 作者:Anant Nawalgaria、Tomasz Świtoń
- 原始标题:How Siemens “slices the elephant,” advancing agentic workflows for industrial software development
- 原文:https://cloud.google.com/blog/products/ai-machine-learning/how-siemens-sliced-the-elephant-modernizing-legacy-code-with-agentic-workflows/
素材包
references/2026年6-7月AI工程博客资料包/2026年6-7月AI工程博客资料包.md
引用边界
- 原文明确说明了数亿行代码规模、多类分散资料、五个专业 Agent、每步人工审核和控制面板迁移试点。
- 原文只给定性效果,未公开提效百分比、成本、失败率或完整对照实验。
相关观看入口
资料核验日期:2026-08-23。