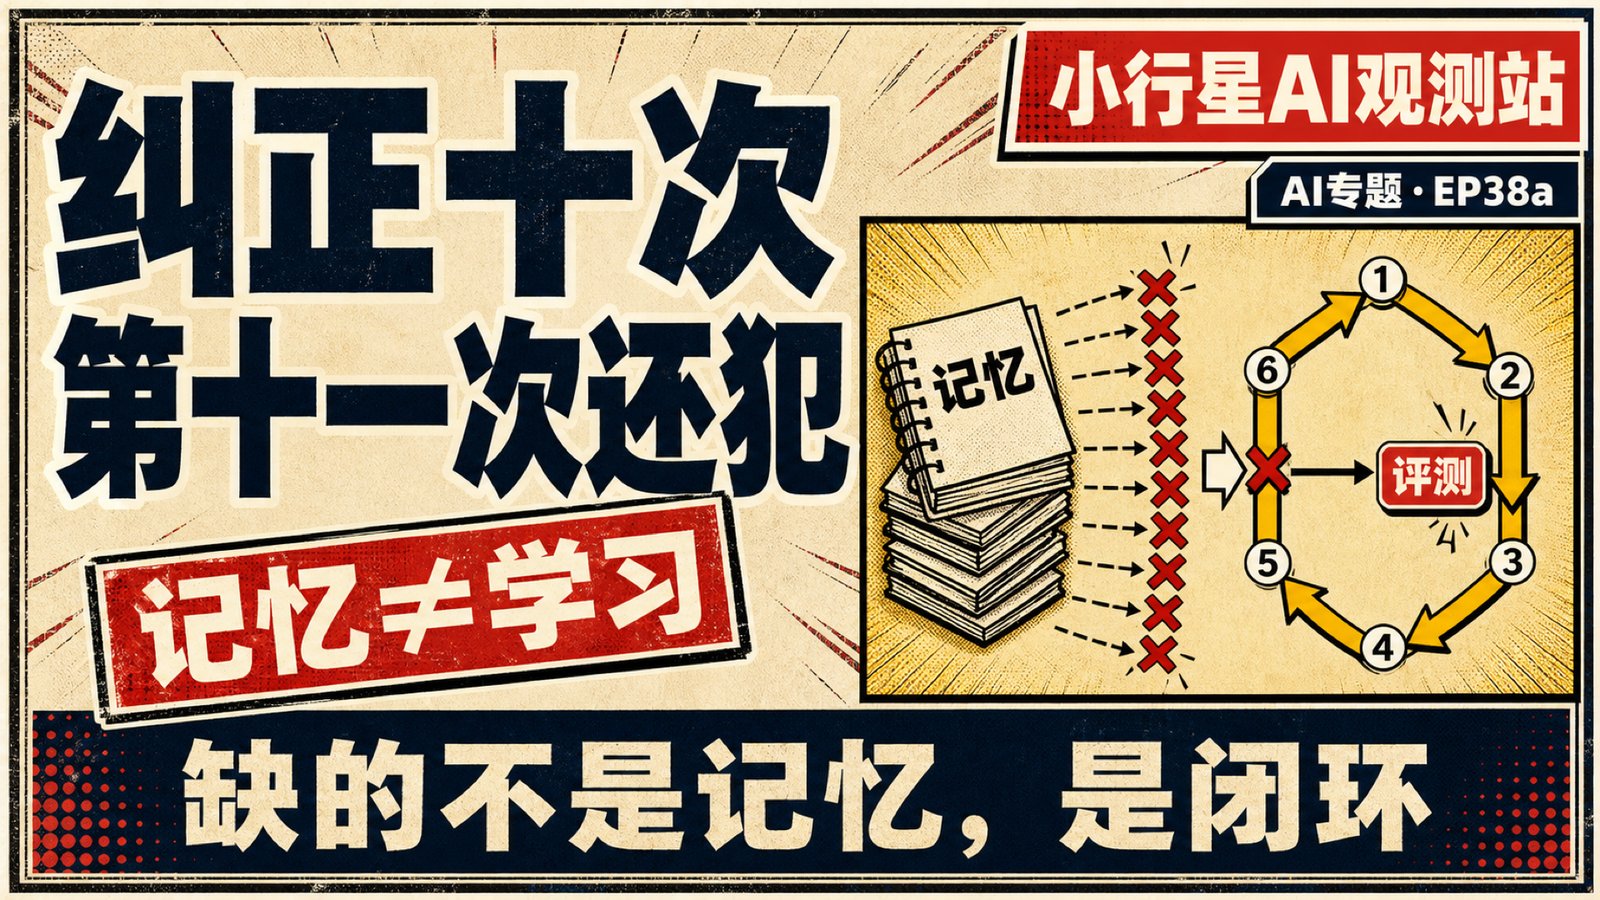
导语:真正会变好的系统,先学会不乱改。本文融合自我进化智能体四部曲体系:从纠错信号留存、专家经验转评测用例、自修改权限锁到上线门禁机制,构建完整的系统自愈闭环。
逐页 Narration — Topic 38a · 纠正十次还犯,缺的不是记忆
节奏纪律:三个误区各自独立成句收尾,不重复“自我进化”这个词;Salesforce 的边界只钉一次——有界修改加草稿合并请求,不是无人监督直接上线。
01. 纠正了十次,第十一次又犯了
你纠正了它十次。第十一次,它又犯了。
你很确定它记住了——因为你能看到对话历史里,每次你都说得清清楚楚。但它记住的,是“这次的正确答案”。它不知道错发生在哪一层:是它没听清你的需求?是它抽错了字段?是它调了一个不该调的工具?还是模型本身就搞混了?
记住了答案,跟知道错误在哪——是两件事。
02. 纠正十次,第十一次照样犯
今天这期视频要回答一个问题:一个智能体,怎样才有资格说自己“真的在变好”?
不是“它记住了什么”——那是记忆功能。不是“它改了自己的提示词”——那可能只是漂移。是问:“变好”这件事,能不能被证明,而不只是被宣称。
接下来四期视频,我们会拆四家公司的工程实践。它们做的事完全不同——代码评审、税务申报、技能模块训练、运行外壳调优——但最后走到了同一条路上。
先从最基本的问题开始:为什么记忆、自己改提示词,还有多个智能体互评,都不等于自我进化?
03. 三个熟悉的答案,都不是自我进化
先把三个最常见的答案摆在桌上。
第一,给它长期记忆。第二,让它失败后自己改提示词。第三,让多个智能体互相点评、互相打分。
这三件事都有用,但都不能单独证明系统真的学会了。下面逐个拆开。
04. 记住答案,不等于修掉错误
先说记忆。
给智能体加长期记忆,现在几乎是标配。它能记住你的偏好和历史对话,让连续使用更顺畅。但记忆改变的是下次调用的上下文,它不自动证明系统能力变强了。
为什么?因为一个错误从发生到影响结果,中间经过好多层。可能是抽取层认错数字,可能是映射层对错规则,可能是工具层调用过时接口,也可能是模型推理断了。记忆存的是这次正确答案,却没有标出上次错误发生在哪一层。
所以下次换几个参数,错误可能从另一层冒出来。你存了十次正确答案,第十一次它换个姿势再犯,因为根因没有被定位。特定场景下的正确答案,还可能在新场景里变成新的错误源。
第一句话:记忆改变上下文,不自动改变系统能力。修错误,需要坐标。
05. 没有三道门,修改只是配置漂移
第二个常见说法:让智能体失败后重写自己的提示词,就是在学习。
听起来合理。它反思哪里做错了,再修改指令。但改完以后,任务甲可能好了五个点,任务乙却差了十个点。没有回归测试,你不知道。它修到的是根因,还是只压住当前案例?没有留出验证集,你也不知道。改坏了能不能退回上一个版本?没有版本控制,就不能。
真正受控的训练至少有三道门。第一,学习率,限制每次改多少。第二,留出验证集,在没参与修改分析的任务上检查效果。第三,版本和回滚,改坏了能回到已知好的版本。
没有这三道门,每次修改看起来都有道理,累积起来却没人说得清哪个版本更好。这不是训练,是配置漂移。
第二句话:自己改了,不代表自己学会了。
06. 共识可以降噪,但不能制造真值
第三个误区:让多个智能体互相点评、互相打分,它们自然会纠错。
这个办法能降低单一模型的随机错误。但它有一个致命假设:多个概率系统互相讨论,就能产生真值。不能。
如果三个模型都用了同一条过时的税务规则,它们会互相确认,给彼此高分,然后一起错下去。共识只能说明它们意见一致,不能说明事实正确。
真值来自系统外部。它可能是领域专家依据规则和证据作出的判断,也可能是有明确答案的测试。后面会看到,开放人工智能公司的税务智能体不是让模型互评,而是捕获从业者在真实申报流程里的修改,再把经过审核的重复差异变成评测。
第三句话:多个智能体互评可以降噪,但不产生真值。
07. 四家公司,一条路
三个误区拆完了。接下来看四家怎么做对了。
四家公司在做完全不同的事。Salesforce 在做代码评审的自动改进。开放人工智能公司在做税务申报智能体。微软研究院在做技能模块的自动训练。英伟达在做运行外壳的自动调优。
入口不同,但它们的控制逻辑几乎一致。我先把共同结构画出来,然后今天重点讲第一块拼图——Salesforce。
08. 六步闭环:一步不能少
四家共同的结构是六步。
第一步,采集信号:从生产追踪、专家修正、评审评论或者测试失败里拿反馈,不是一句“用户不满意”。第二步,提炼模式:过滤噪声、去重、聚类,区分一次性问题和重复失败。第三步,制造真值:把模式转成有明确成功条件的评测、结构校验或者测试用例。第四步,有界修改:限制改什么文件、改多少行、改几次——不让一轮改炸。第五步,独立验证:留出集、重复运行、确定性规则和全量回归。第六步,版本发布:人工审查、草稿合并请求、影子运行、灰度、回滚——不直接热更新生产核心。
今天重点讲第一步。
09. 一个会停止改变的闭环
Salesforce 怎样从评审意见里采集信号,以及它做了一件反直觉的事——设计了一个会停止改变的闭环。
10. 评审评论,先过四层滤网
二零二六年七月十七日,Salesforce 工程博客发了一篇文章,中文题目是《闭环:怎样构建自我改进的人工智能系统》,英文原题在画面上。
他们先做了一个生成技能目录的生成器。贡献者用它产出技能模块,再通过合并请求接受人工评审。团队把这些评审评论反向喂给生成器,让生成器本身形成自我改进闭环。文章后半段还把同样的架构用于自动代码评审机器人,但那是另一个实例。
先看它怎么采集信号。信号来源是真实的代码评审评论。但不是每条评论都有用,所以做了几层过滤。过滤掉作者的回复——作者当然会说自己的代码没问题。过滤掉机器人和持续集成的噪声——那些是自动化输出,不是反馈。用大模型做去重——十个人说“这个变量名不好”只算一条。最后按频率乘以严重度排序——出现次数多、并且影响大的排前面。
到这一步,信号已经比“用户不满意”精确了很多。但这里有一个关键设计。
11. 攒够 15 个 PR,才触发一轮
Salesforce 设了一个触发阈值:至少十五个已合并的技能生成合并请求,才触发一轮优化。
为什么是十五个?因为少于这个数量,你过拟合的是单个评审者的偏好,不是系统性的失败模式。一个人说“你这里写得不好”,可能是他的风格;十五个不同的合并请求里反复出现同一类问题,那才是模式。
信号攒够了,进入有界修改。
12. 每一轮的约束,写死在前面
Salesforce 跑了六轮优化。每一轮的限制是:最多应用五项改进。最多修改一百行代码。任何一层评测回归——立即中止。
三层评测是什么?第一层是触发准确率:二十条查询里,十条该触发、十条不该触发,还要放进八十多个竞争技能同时存在的环境。第二层是结构校验:复用仓库的确定性规则,检查命名、元数据和文件引用。第三层是语义评分:只有机械规则判断不了的内容质量,才交给按评分表工作的模型评审。任何一层退步,这轮就不做了。
然后是版本控制。通过门禁的修改不直接上线。它只生成一个草稿状态的合并请求。核心目录的修改保留人工审查。
13. 六轮优化,只有两轮真正改了
到这里,闭环的结构清楚了。但接下来才是最有意思的部分。
六轮优化,只有两轮真正应用了改进。另外四轮没有落地。原文明确说其中三轮在门槛检查时就因为新信号不足而中止;其余轮次即使运行,也可能不产生值得落地的修改。系统自己判断“这轮不该改”,然后停了。
这不是 bug,这是设计。如果信号变少了,闭环自然停止。它不会为了“证明自己在改进”而硬改。等到评审标准变了、评论量重新上来,闭环被再次唤醒。
这跟市面上“自我进化”产品完全不同。那些产品的设计目标是“越用越聪明”——每次交互都要学到点什么、改点什么。Salesforce 的设计目标是“有证据才改,没证据就停”。
14. 两种「自我进化」
一个会停止改变的系统,比一个永远在改的系统,可信得多。
为什么?因为永远在改的系统,你不知道它是在变好还是在漂移。会停止的系统告诉你:至少在它停下来的那段时间,当前版本是经过验证的。
15. 带走三句话
今天讲了三件事。
第一,记忆不等于学习——记忆改变下次上下文,不改变系统能力。错误有坐标,记忆没有。第二,自己改提示词不等于训练——没有学习率、留出集和回滚的重写,是配置漂移。第三,多个智能体互评不等于真值——共识降低随机噪声,但不产生真值。真值来自外部标准。
然后看了 Salesforce 的闭环。它做了几件反直觉的事:十五个合并请求才触发——防过拟合。每轮最多改五项、一百行——限爆炸半径。三类证据任一退步就停——安全优先。六轮只做了两轮——没有足够改进就停。通过的修改只进草稿合并请求——不直接上线。
16. 第一步亮了,下一站:真值
今天讲了闭环的第一步:怎样采集信号。Salesforce 的信号是代码评审意见——有人说好,有人说不好,系统按频率和严重度筛选。
但评审意见有一个问题:它是主观的。不同评审者标准不同。它告诉你“哪里有问题”,但不告诉你“什么是对的”。
如果信号不是主观意见,而是专家在真实业务里改出来的字段差异呢?开放人工智能公司与合作方披露了七千份试点申报。系统会捕获从业者干预留下的预测值、修改值和最终申报值。经审核确认可行动的重复差异,不再只是意见,而能成为真值信号。
下一期,我们拆开放人工智能公司的税务智能体:七千份试点处理量里产生的专家修正,怎样从“改了一处”变成“定义了一个评测”。
参考资料与延伸阅读
本文事实来源
- S01 · Salesforce — Salesforce 代码评审 Skill 自我改进闭环(评审评论→信号→有界修改→Draft PR)
事实边界(口播已逐条标注)
- Salesforce 六轮优化只应用两轮:原文数据,体现「信号不足即停」的设计意图。
相关观看入口
资料核验日期:2026-08-23。技术在持续演进,具体接口与行为请以官方最新文档与发布记录为准。