01. NVIDIA 解决什么问题
二零二六年七月七日,NVIDIA Technical Blog 发布了一篇工业告警分析文章,作者是 Helge Aufderheide。
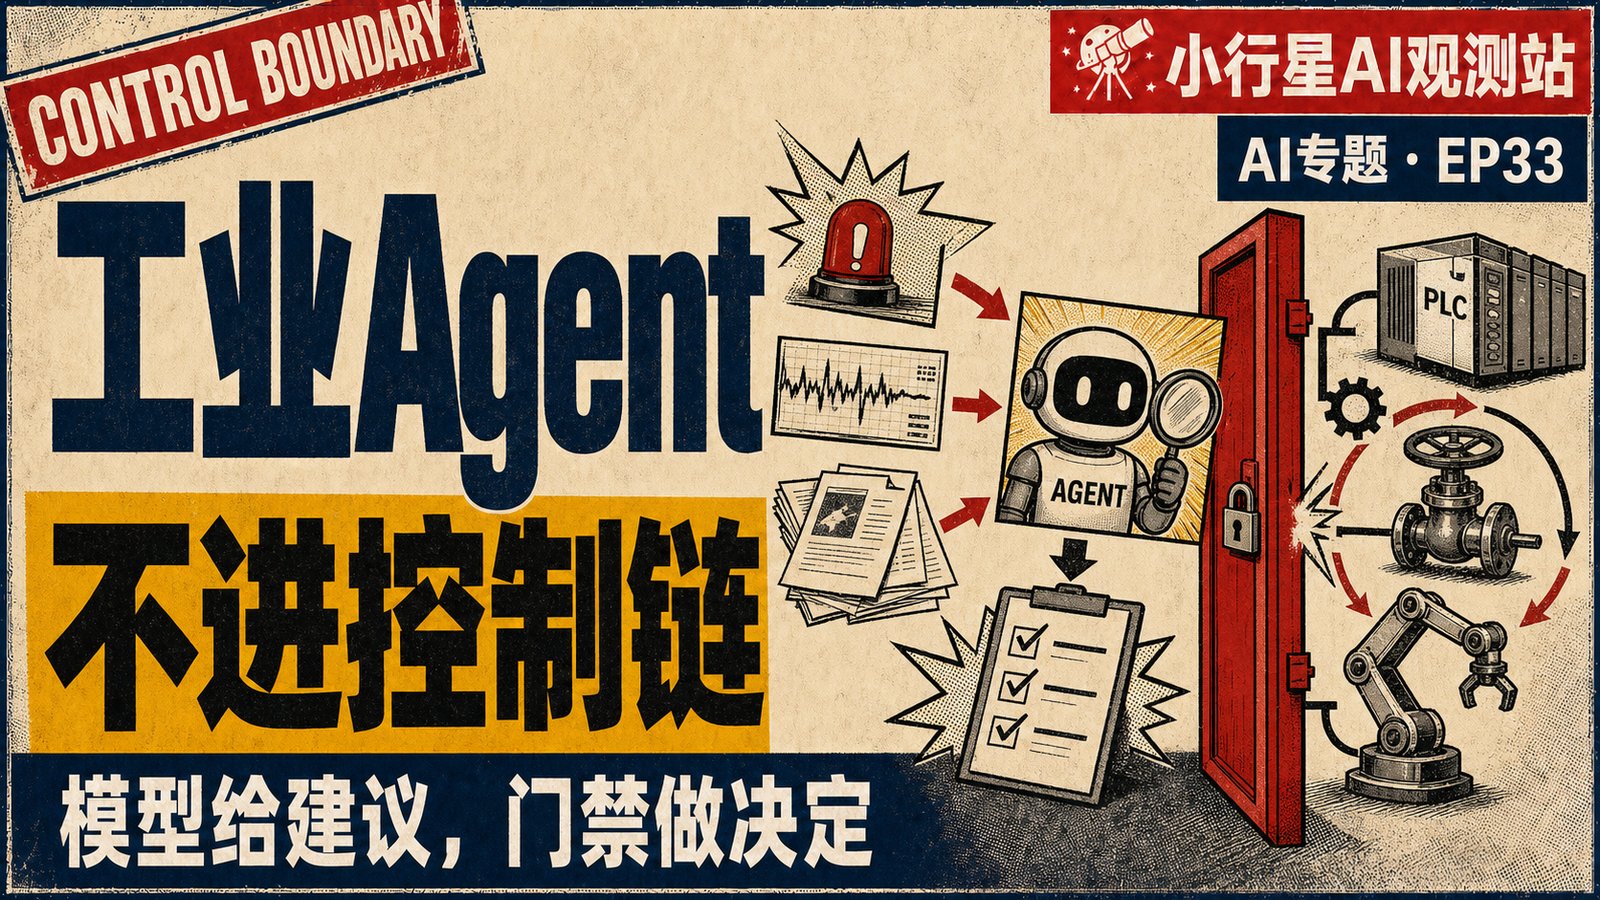
它讨论的不是让 Agent 直接控制工厂,而是一个更具体的问题:当监控系统已经发出一条告警,怎样让 Agent 在几秒内找齐证据、判断可能原因,并给技术员一份可以继续处理的建议。
这条边界非常重要。因为工业系统真正缺少的,通常不是更多告警,而是怎样把分散在传感器、历史工单、维修手册和专业分析工具里的信息,快速拼成一次可靠判断。
02. 一条告警为什么仍然很难处理
一条“温度过高”或者“振动异常”的告警,看起来只有几个字,背后的排查却可能很长。
技术员要先确认同一台设备过去是否出现过类似问题,当时怎么处理;再查当前位置和设备型号对应的操作手册;还要判断这次信号是真故障、正常趋势、检修活动造成的波动,还是传感器本身产生的伪影。
这意味着 Agent 不能只看到告警名称,更不能凭模型记忆直接猜答案。它必须先解决证据从哪里来、哪些证据可信,以及哪些判断需要专业算法确认。
03. 第一步不是选模型,而是收紧接口
NVIDIA 先把任务限制成一次单告警分析。
输入是一条告警、对应的传感器数据片段和设备元数据。输出是一份结构化证据包,里面分别记录观察结果、根因假设、可能的处置方法、建议动作,以及支撑这些结论的工具调用轨迹。
文章还给这个任务设置了秒级延迟预算,因为操作员正在等待当前这条告警的分析结果。
这里最值得注意的是,输出里没有“直接修改设备参数”这一项。Agent 接收的是已经发生的告警,交付的是证据和建议。先把输入、输出和停止位置限定清楚,后面的工具、评测和权限才有办法设计。
04. 把分散证据收进同一个上下文
收到告警以后,Agent 先做证据收集。
近期告警和传感器数据来自结构化查询。更长时间范围的历史记录,可以通过数据仓库继续检索。设备手册、现场操作流程和维修手册,通过文档检索进入上下文。过去的工单和处置结果,则用来回答“这种故障以前出现过没有,哪种处理真正有效”。
这一步不是把所有资料一次性塞给模型,而是围绕当前告警,只取和设备、时间窗口、传感器以及故障代码有关的内容。
模型不应该负责记住整座工厂。它应该拿到一份有来源、能回查、与当前事件直接相关的证据集合。
05. 让专业工具确认信号是不是真故障
证据找齐以后,仍然不能直接生成结论。
像温度过高、振动突增这类通用告警,必须结合具体工况验证。系统可能需要做异常检测、频域分析、趋势预测或者离群值过滤,才能判断轴承是否真的开始失效,还是传感器噪声造成了误报。
这些计算不应该由大模型在文字里“模拟”。Agent 可以根据当前证据选择该调用哪一种分析工具,也可以解释不同结果之间的冲突;但信号处理和数值计算,交给可验证的专业算法。
所以这套架构里,模型不是万能专家。数据系统提供事实,专业工具验证信号,模型负责跨来源组织证据和处理仍然存在的歧义。
06. 把观察、推断和建议明确分开
完成专业分析以后,模型才开始生成结果。
它先写观察到了什么,例如哪个时间窗口、哪组指标出现异常;再写根因假设,也就是这些异常最可能说明什么;接着给出可参考的处置方法和建议动作,并附上使用过的数据、文档和工具轨迹。
把这几部分拆开,不只是为了报告更整齐,而是为了防止模型把“推测”包装成“事实”。技术员可以分别检查:原始观察是否成立,根因解释是否合理,建议动作有没有足够证据支持。
到这里,Agent 完成的是一次可复核的分析,还没有获得执行权限。
07. 建议变成动作之前必须经过门禁
NVIDIA 在建议之后,又增加了策略与置信门禁,并单独进行安全检查。
只有结果置信度足够高,而且建议没有违反既定策略,系统才会给它加上自动派发标记。低置信、证据冲突或者超出策略范围的结果,会带着已经收集好的证据升级给技术员。
这里的自动派发,指的是把结果送进工单或后续处置流程,不是让大模型直接操作设备。模型给出建议,门禁判断这份建议可以流向哪里,这两个职责必须分开。
如果模型既负责生成建议,又能决定自己是否值得信任,那么所谓安全检查就只剩下一次自我评价。
08. 为什么 Agent 应该停在分析层
从这套接口可以看出,Agent 位于告警发生之后、技术员采取行动之前。传感器采集、告警触发和底层安全控制,仍然由原来的确定性系统负责。
因此,“工业 Agent 不应该直接进入实时控制链”,是我根据文章接口做出的工程判断,不是 NVIDIA 原文直接给出的口号。
原因也很具体。文章给 Agent 的是秒级响应预算,而设备保护可能要求毫秒级甚至更低延迟;模型输出存在波动,控制动作却可能不可逆;分析出错可以重新核对,设备动作出错可能直接影响生产和人身安全。
低风险、可逆、能够自动验证的动作,当然可以提高自动化程度。但权限来自外部规则和门禁,不应该来自模型对自己的判断。
09. 每条告警都调用模型也不是终点
把 Agent 限制在分析层,只解决了权限问题,还没有解决长期运行的成本和稳定性。
如果一种告警模式已经反复出现,证据条件和处理路径都很稳定,系统仍然每次调用大模型重新判断,就会继续承担额外延迟、Token 成本和结果波动。
二零二六年六月二十五日,Engineering at Meta 发布了一篇资产分类工程文章,作者是 Rituraj Kirti 和 Vasileios Lakafosis。它讨论的虽然是隐私资产分类,但遇到的矛盾和工业告警很相似:输入包含大量噪声和歧义,后面的生产执行却必须稳定、可解释、可重放。
Meta 给出的原则是,常规生产路径由确定性规则处理,大模型主要负责冷启动、模糊判断和没有见过的长尾情况。
10. 让成熟判断固化成规则
Meta 的做法不是让模型直接把自己的答案写成规则。
系统先组织高质量证据,再把模型建议与人工确认的标签分开;随后用独立评测检查这个判断是否在冻结样本和回归任务上持续成立;只有经过人工审核的稳定模式,才会被提升为带版本、可审计的确定性规则。
迁移到工业告警场景,含义很清楚:Agent 可以帮助团队发现新的关联、阈值和处置模式,但一种判断只有经过真实数据验证和人工批准,才能进入日常规则路径。
这样,常见事件越来越多地走低延迟规则,模型留下来处理真正需要跨来源推理的新问题。系统不是不断扩大大模型的权限,而是随着经验增加,逐步缩小它在常规生产路径中的面积。
11. 固定流程不应该让模型重新猜
即使保留大模型,整条告警分析流程里仍然有大量固定步骤:先读告警,再收集证据;需要时调用专业分析;生成建议以后必须经过门禁;失败要重试,超时要升级,关键动作要等待人工确认。
二零二六年七月一日,Google Developers Blog 发布了一篇介绍 ADK 2.0 设计原因的文章。作者包括 Swapnil Agarwal、Alan Blount 和 Frank Guan。
Google 把执行路由和语言推理明确分开。固定顺序、状态传递、错误处理、工具调用和人工审批由工作流代码控制;只有理解非结构化资料、处理政策例外、形成根因解释这类开放节点,才调用大模型。
如果系统已经知道第二步必须跟在第一步后面,就没有必要每次消耗 Token,让模型重新猜一次流程。
12. 一条告警应该经过怎样的控制链
把三篇文章放回同一条告警,就能得到一条很具体的控制链。
第一层,确定性监测系统采集实时信号并触发告警。第二层,证据服务围绕这条告警检索历史数据、手册和过去工单。第三层,专业算法验证故障模式,排除趋势、噪声和传感器伪影。第四层,大模型综合证据,生成观察、根因假设和处置建议。第五层,策略、置信和人工门禁决定结果进入工单、交给技术员复核,还是直接拒绝。
真正的设备控制仍然留在经过验证的确定性系统里。大模型可以影响下一步判断,但不能绕过门禁,直接把自然语言变成设备动作。
这条链的价值,是每一层都有明确输入、明确输出和明确责任。哪一步出了问题,可以回放证据和工具轨迹,而不是只得到一句“模型当时是这么判断的”。
13. 上线前检查五个问题
所以,评审工业 Agent 时,先不要问它能调用多少工具,而要检查五件事。
它处理的是一条可验收事件,还是模糊地接管整个系统?事实和历史证据由哪些数据源提供,能不能回查?数值信号有没有经过专业算法验证?建议变成工单或动作以前,是否存在模型无法绕过的策略、置信和人工门禁?反复验证过的稳定判断,能不能退出大模型路径,晋升为版本化规则?
这五个问题答得越清楚,Agent 才越接近生产系统;答不清,模型能力再强,也只是把不确定性接到了更危险的位置。
参考资料与延伸阅读
本文事实来源
NVIDIA
- 发布方:NVIDIA Technical Blog
- 发布日期:2026-07-07
- 作者:Helge Aufderheide
- 原始标题:Building an Analysis AI Agent for Industrial Alarm Management with NVIDIA Nemotron
- 原文:https://developer.nvidia.com/blog/building-an-analysis-ai-agent-for-industrial-alarm-management-with-nvidia-nemotron/
Meta
- 发布方:Meta Engineering
- 发布日期:2026-06-25
- 作者:Rituraj Kirti、Vasileios Lakafosis
- 原始标题:Privacy-Aware Infrastructure in the AI-Native Era: An Asset Classification Case Study
- 原文:https://engineering.fb.com/2026/06/25/security/privacy-aware-infrastructure-in-the-ai-native-era-an-asset-classification-case-study/
- 发布方:Google Developers Blog
- 发布日期:2026-07-01
- 作者:Swapnil Agarwal、Alan Blount、Frank Guan
- 原始标题:Why we built ADK 2.0
- 原文:https://developers.googleblog.com/why-we-built-adk-20/
编辑边界:NVIDIA 的 auto-dispatch 指工单标记,不是设备级直接控制;“LLM 不进入实时控制链”是基于三篇资料形成的工程判断,视频中已明确标注为判断。
相关观看入口
资料核验日期:2026-08-23。