把一句话交给大模型:“请把 AI Agent 和 Harness 的原理做成一条能发布的视频。”几秒后,模型给出了一段文案。任务完成了吗?
没有。研究、核验、配图、配音、渲染、检查和发布,一个都没有因为这次回答而自动发生。
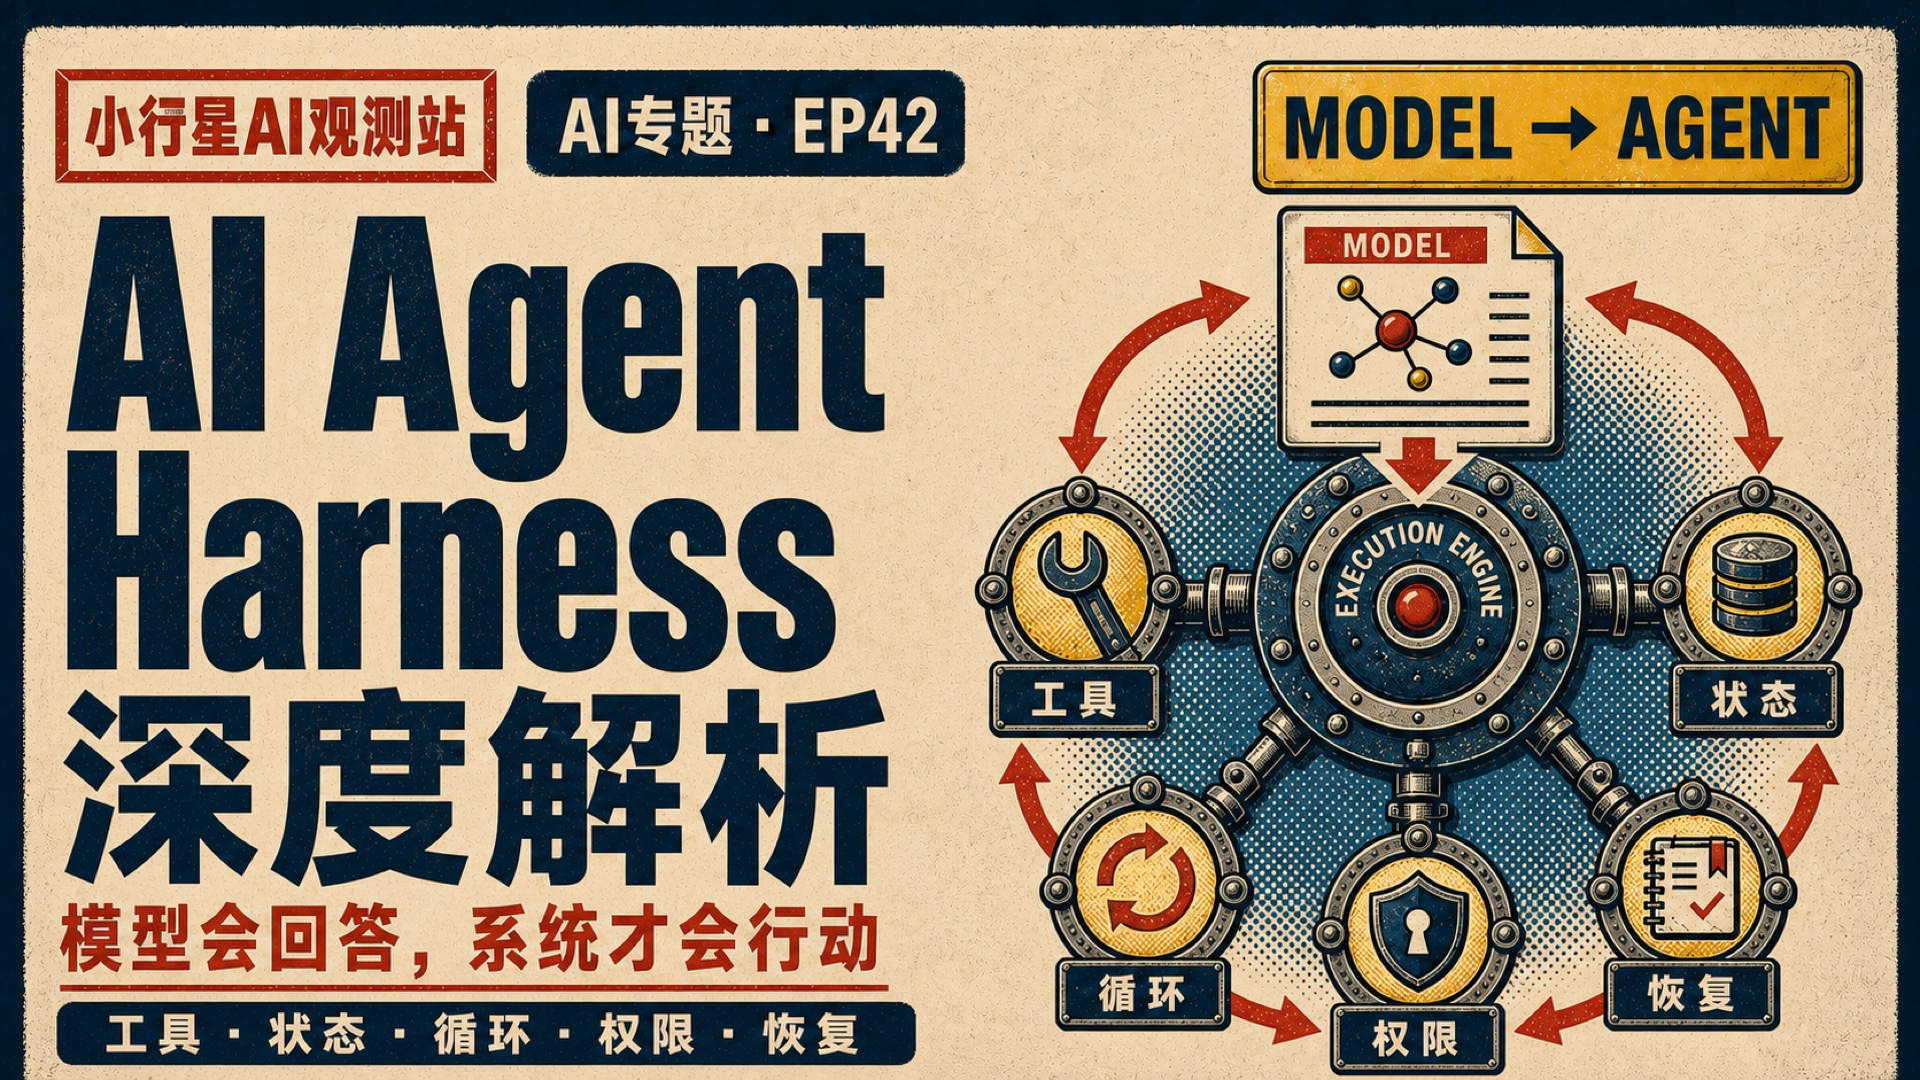
这就是理解 AI Agent 的起点:模型完成的是一次判断,Agent 面向的是一个跨步骤目标;把判断变成可靠行动的那套运行系统,就是 Harness。
一次模型调用,边界在哪里
最普通的模型调用有清楚的起点和终点:应用把消息和工具定义送入模型,模型返回文本或一次工具调用请求,本轮推理结束。
模型不会因为“提出了搜索”就自动获得网络权限,也不会因为“建议保存文件”就知道文件是否真的写入成功。它更不会天然保留项目进度、判断视频是否渲染完成,或者在进程崩溃后从断点恢复。
OpenAI 的 Agent 指南把 Agent 定义为能代表用户独立完成任务的系统,并明确区分了普通单轮 LLM 应用与由模型控制工作流执行的 Agent。这里的关键词不是“会聊天”,而是控制执行、使用工具、观察结果,并在边界内持续运行。
Workflow 与 Agent,不要混为一谈
确定性 Workflow 由开发者预先写好步骤:先 A,再 B,失败走 C。路径稳定、规则清楚的任务通常优先用这种方式,因为它更便宜、更容易测试。
Agent 则让模型根据当前状态动态决定下一步:选择哪个工具、是否需要补资料、继续还是停止、是否应把控制权交回给人。它适合路径无法完全预写、下一步依赖刚刚获得的反馈,或者需要处理大量非结构化信息的任务。
Anthropic 在《Building effective agents》中也强调从简单、可组合的模式开始,只在确有收益时增加自主性。换句话说,Agent 不是 Workflow 的升级皮肤;它是在不确定路径上付出更高成本,换取动态决策能力。
一个可行动的 Agent 有哪些部件
从工程角度,可以把端到端 Agent 拆成五个基本部件:
- Goal:用户真正要完成的目标与验收条件。
- Model:根据上下文做出下一步判断。
- Tools:读取数据或改变外部环境的能力。
- State:当前计划、已完成步骤、工作区和预算。
- Loop:把判断、执行、观察和更新反复连接起来。
Harness 位于模型外部,负责组装这些部件。Microsoft Agent Framework 的 Harness 文档把上下文工程、状态管理、工具执行、持久化、人工审批、遥测与韧性都放在这一运行边界中。不同框架的模块名称可能不同,但职责非常接近。
因此可以先记住三句话:
- MODEL 负责判断。
- HARNESS 负责把判断安全、可恢复地落到环境里。
- AGENT 负责围绕目标持续行动,直到完成、失败或请求人工接管。
一次 Tool Call 到底发生了什么
工具调用不是“模型按下了一个按钮”,而是一段跨边界协议。
第一步,Harness 把系统指令、用户目标、必要历史、当前状态,以及工具的名称、说明和参数 Schema 组装成模型请求。工具定义是一份机器可读的能力契约。
第二步,模型可以直接回答,也可以返回结构化 Tool Call,例如选择 search_sources 并给出查询参数。此时模型只表达了行动意图,还没有执行任何外部操作。
第三步,Harness 解析调用,确认工具存在,校验参数 Schema,再检查当前主体是否有权限、动作是否需要人工批准。通过后才把请求路由给真实工具。
第四步,工具在浏览器、文件系统、数据库或沙箱中执行,返回结构化结果。Harness 将 Tool Result 和调用标识写回上下文,模型读取新的 Observation,再决定下一步。
这条链路把“模型想做什么”和“系统允许做什么”分开了。参数错误、越权请求和高风险副作用,应在进入外部环境之前被挡住。
Agent Loop:循环必须有出口
把“判断—行动—观察”重复起来,就是 Agent Loop。ReAct 论文讨论的核心,也是让推理决策与环境行动交错进行,而不是一次性生成完整答案。
工程实现不需要保存或展示模型的私有思维链,但必须保存可检查的外部事实:模型提出了什么调用、工具返回了什么、状态怎样变化、为什么停止,以及最终产物在哪里。
可靠循环至少要有四类出口:
done:验收条件已经满足;failed:工具持续失败,继续执行没有意义;needs human:缺少权限、信息或高风险批准;cancelled:用户或上层系统终止任务。
Harness 还应设置最大轮次、时间、Token 和成本预算。没有 Stop Reason 和资源上限,Agent 很容易从“持续解决问题”退化为“更昂贵地原地打转”。
Context、State、Memory 和 Checkpoint
模型 API 不会跨调用自动记住整个项目。每一轮,Harness 都要重新选择系统指令、历史消息、工具结果、当前计划和工作区摘要,再把它们组装进上下文。
当上下文窗口接近上限时,系统可以裁剪旧消息或把历史压缩成摘要。但压缩会丢失细节,错误摘要还可能把偏差持续传下去。因此,关键事实不应只存在于聊天记录中。
四个容易混淆的概念可以这样区分:
- State:任务此刻进行到哪里;
- Memory:跨任务仍有价值的偏好或经验;
- Artifact:文件、代码、报告等可独立检查的成果;
- Checkpoint:恢复执行所需的最小状态快照。
Microsoft Agent Framework 的 Checkpoint 文档展示了工作流状态的保存与恢复机制。真正可靠的恢复不是让模型根据模糊摘要“猜之前发生了什么”,而是从已确认的检查点和外部成果继续。
可靠性:坏 JSON、重试和重复副作用
模型输出结构化数据,不代表这些数据天然有效。进入工具前仍要执行 Schema 校验、类型检查、枚举约束和业务规则。坏 JSON 不能直接变成真实动作。
重试也不是简单地“失败就再来一次”。读取接口通常可以安全重放,但发送消息、创建订单、扣款或修改记录可能产生重复副作用。AWS Builders’ Library 对幂等 API 的讨论给出了一条重要原则:只有能识别同一次意图,并对重复请求返回语义一致结果,重试才真正安全。
因此,高影响工具需要幂等键、去重记录、超时、退避和明确的最终状态。Harness 的价值不只是让 Agent 多试几次,而是确保每一次尝试都不会把现实世界弄得更乱。
多 Agent 不是免费并行
复杂项目可以由管理者把研究、脚本、视觉和 QA 分给多个 Agent,也可以通过 Handoff 把控制权交给更合适的专家。两种方式都依赖清楚的输入输出契约和必要状态传递。
但多 Agent 会引入额外 Token、状态同步、权限面、调度等待和结果合并成本。实践中应先把单 Agent 的工具说明、上下文和验证做清楚,再证明并行确实带来收益。否则,多 Agent 只是把一个不稳定循环复制了很多份。
安全:工具结果也可能带着攻击指令
外部网页、邮件、文档和日志都属于不可信输入。它们可能包含间接 Prompt Injection,诱导模型忽略原始目标、泄露数据或调用高风险工具。
OWASP 对 Prompt Injection 的缓解建议包括最小权限、隔离不可信内容、人工批准和纵深防御。落到 Harness 上,意味着:
- 读取工具和写入工具分开授权;
- 高风险参数在模型之外做确定性校验;
- 敏感动作暂停并等待人工批准;
- 工具返回值不能自动升级为系统指令;
- 全链路保留操作者、输入、结果与审批记录。
Guardrail 是多层防线中的一层,不是让任意自主行为自动变安全的护身符。
可观测,才能评测和改进
只看最终答案,很难知道 Agent 为什么成功或失败。可评测的 Harness 应记录轮次、工具调用、错误类型、重试次数、人工介入、延迟、成本和最终 Artifact,并让完成声明可以被外部验证。
重复出现的失败应转成确定性反馈:Schema、权限规则、回归测试、提示词约束或新的检查点策略。评测的对象也不应只写“某模型表现如何”,而应记录模型、Harness、工具、权限、预算和验证器的组合。
从哪里开始做一个 Agent
普通团队不需要一开始就搭建复杂的多 Agent 平台。一个可落地的最小闭环是:
- 选择结果可验证、权限较低的任务;
- 写清输入、产物、完成条件和失败预算;
- 给工具定义严格 Schema 与最小权限;
- 用结构化状态记录计划与进度;
- 给循环设置 Stop Reason 和资源上限;
- 对副作用工具增加审批、幂等和审计;
- 用测试或独立审核验证最终 Artifact;
- 把真实失败沉淀成回归案例。
模型决定单步判断的上限;Harness 决定这些判断能否在长程任务里稳定落地;工具、业务边界与评测,决定 Agent 最终有没有实际价值。
参考资料与延伸阅读
本文事实来源
- OpenAI:A practical guide to building agents
- Anthropic:Building effective agents
- ReAct:Synergizing Reasoning and Acting in Language Models
- Microsoft Learn:Agent Harness
- Microsoft Learn:Workflow Checkpoints
- AWS Builders’ Library:Making retries safe with idempotent APIs
- OWASP:LLM01 Prompt Injection
相关内容
资料核验日期:2026-08-25。